Trong nghiên cứu khoa học dữ liệu và phân tích mạng xã hội, việc thu thập dữ liệu thực tế từ các nền tảng trực tuyến đóng vai trò vô cùng quan trọng. Trước đây, nhiều người dùng thường thắc mắc liệu phần mềm Stata có khả năng nhập trực tiếp dữ liệu từ mạng xã hội Twitter hay không. Để giải quyết nhu cầu này, việc phát triển các lệnh mở rộng tận dụng giao diện lập trình ứng dụng Java cải tiến trên các phiên bản Stata hiện đại đã mang lại lời giải hoàn hảo. Bài viết này sẽ hướng dẫn bạn cách sử dụng công cụ twitter2stata để kết nối, xác thực và khai thác dữ liệu từ Twitter về môi trường làm việc Stata một cách nhanh chóng.
Cài đặt công cụ twitter2stata
Trước khi tiến hành khai thác thông tin, bạn cần thực hiện cài đặt bộ công cụ này trực tiếp từ kho lưu trữ SSC của cộng đồng Stata. Hãy mở phần mềm và chạy dòng lệnh sau trong cửa sổ dòng lệnh.
1ssc install twitter2stata, replaceCác tính năng khai thác dữ liệu cốt lõi
Sau khi quá trình cài đặt hoàn tất, bộ lệnh cung cấp cho bạn nhiều tùy chọn mạnh mẽ để truy xuất dữ liệu phù hợp với từng mục tiêu nghiên cứu cụ thể.
Tìm kiếm bài viết theo từ khóa
Nếu nghiên cứu của bạn cần thu thập các bài viết có chứa nội dung hoặc chủ đề cụ thể, bạn có thể thực hiện tìm kiếm bằng cú pháp dưới đây.
1twitter2stata searchtweets "search_string"Tìm kiếm thông tin người dùng
Để tìm kiếm thông tin của các tài khoản dựa trên một cụm từ khóa tìm kiếm cụ thể, lệnh dưới đây sẽ giúp bạn liệt kê danh sách tài khoản tương ứng.
1twitter2stata searchusers "search_string"Truy xuất dữ liệu của một tài khoản cụ thể
Khi đã xác định được định danh người dùng hoặc tên tài khoản chính xác, bạn có thể tải toàn bộ hồ sơ thông tin của tài khoản đó về Stata.
1twitter2stata getuser "userId_or_userName"Thu thập danh sách tương tác và mạng lưới người dùng
Để phân tích mạng lưới xã hội, bạn có thể dễ dàng tải về danh sách những người theo dõi, danh sách đang theo dõi, các lượt thích hoặc các nhóm danh sách của một người dùng cụ thể bằng các lệnh sau.
1twitter2stata likes "userId_or_userName"
2twitter2stata following "userId_or_userName"
3twitter2stata followers "userId_or_userName"
4twitter2stata lists "userId_or_userName"
Trích xuất dữ liệu từ các danh sách nhóm chuyên biệt
Bên cạnh đó, nếu bạn quan tâm đến một danh sách nhóm được phân loại sẵn trên Twitter, hai câu lệnh sau sẽ hỗ trợ thu thập thông tin thành viên cũng như các bài viết được đăng tải trong nhóm đó.
1twitter2stata listusers "listId_or_listName"
2twitter2stata listtweets "listId_or_listName"
Hướng dẫn thiết lập tài khoản và ứng dụng Twitter
Để các câu lệnh trên có thể hoạt động ổn định và nhận được giới hạn băng thông tải xuống tốt nhất từ hệ thống, bạn cần sở hữu một tài khoản Twitter và đăng ký một ứng dụng dành cho nhà phát triển để lấy các khóa bảo mật.
Đầu tiên, hãy truy cập vào trang quản lý ứng dụng của Twitter tại địa chỉ apps.twitter.com sau khi đã đăng nhập tài khoản. Giao diện trang quản lý sẽ xuất hiện như bên dưới.
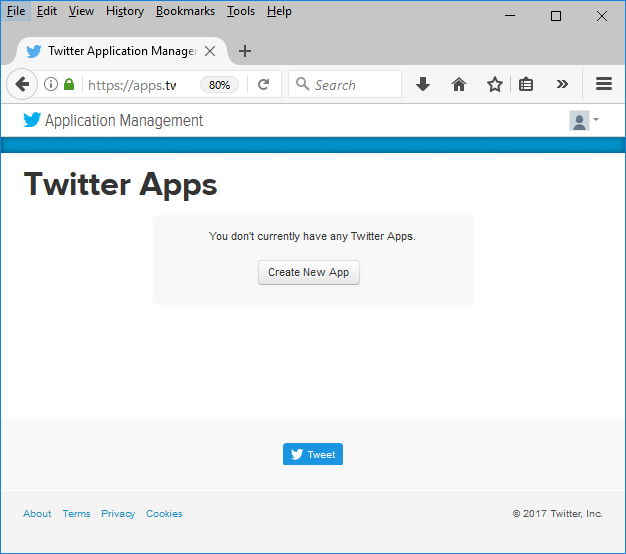
Tiếp theo, bạn nhấp chuột vào nút tạo ứng dụng mới trên màn hình.
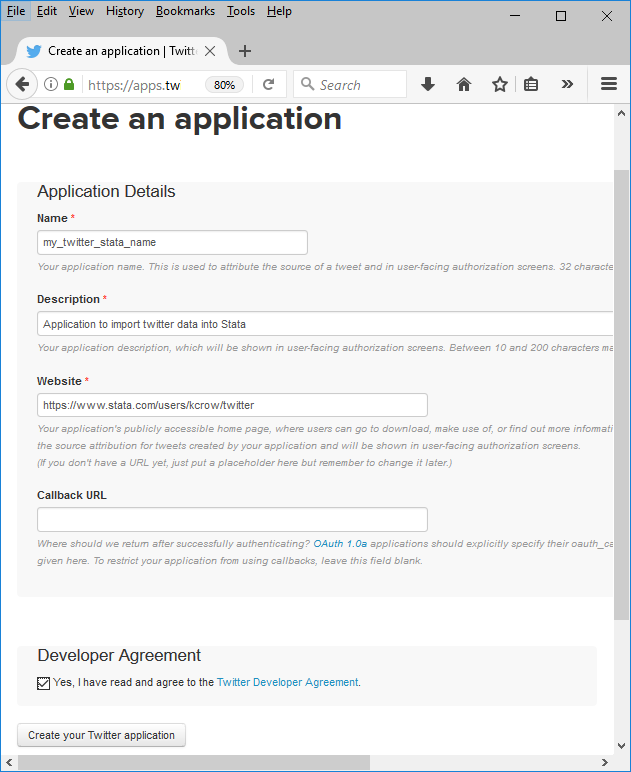
Tại đây, hệ thống yêu cầu điền đầy đủ thông tin vào ba trường bắt buộc bao gồm tên ứng dụng, mô tả ứng dụng và địa chỉ trang web của bạn. Lưu ý rằng tên của ứng dụng phải là duy nhất trên toàn hệ thống, vì thế bạn có thể cần thử một vài tên khác nhau trước khi thành công. Sau khi hoàn thành biểu mẫu, hãy nhấp vào nút tạo ứng dụng Twitter của bạn.
Sau đó, bạn chuyển sang thẻ quản lý khóa và mã truy cập rồi nhấp vào nút tạo mã truy cập để hệ thống tự động sinh các chuỗi ký tự bảo mật cá nhân.
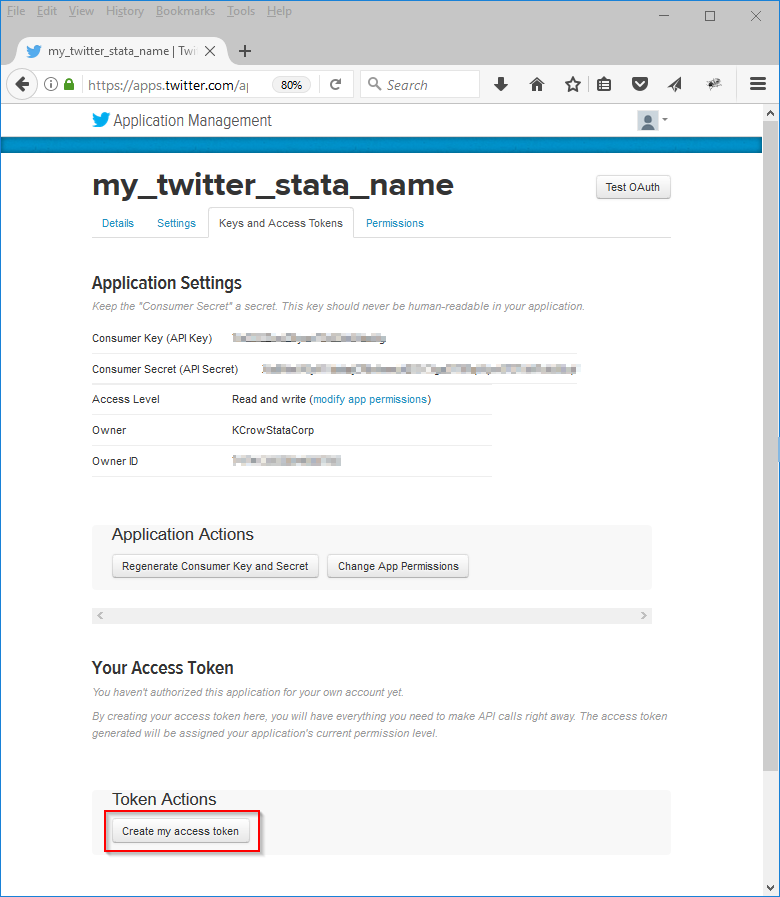
Lúc này, hệ thống sẽ cung cấp cho bạn bốn chuỗi mã khóa quan trọng bao gồm Consumer Key, Consumer Secret, Access Token và Access Token Secret.
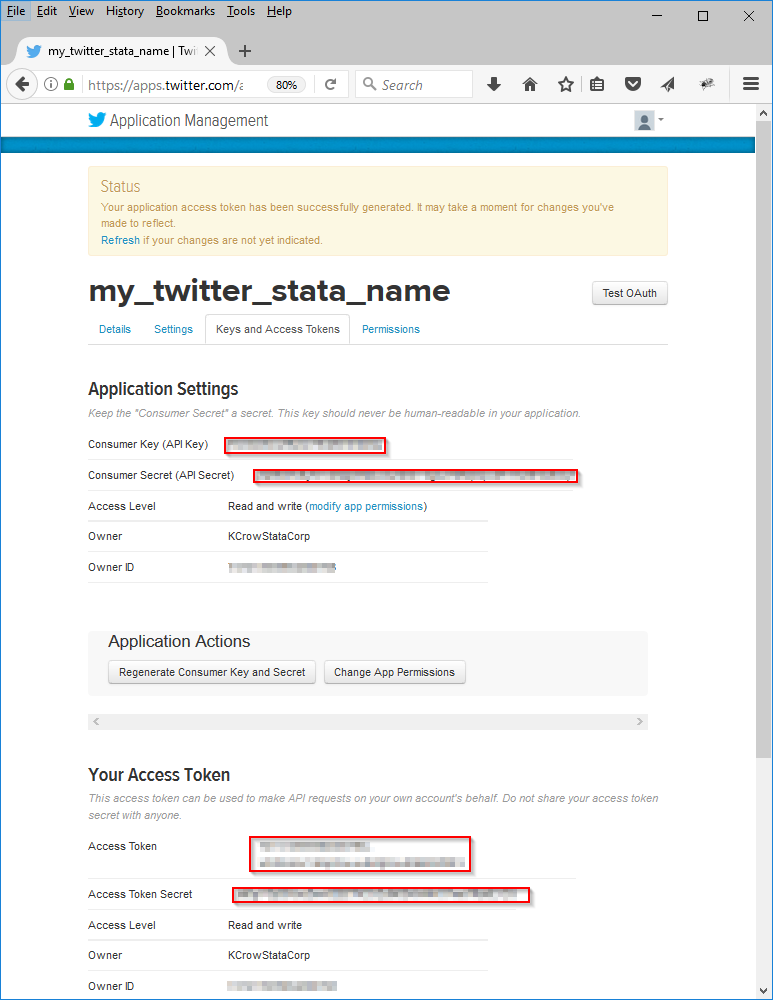
Hãy sao chép các chuỗi mã này và dán chúng vào một tệp lệnh do-file dưới dạng các biến cục bộ để sử dụng lâu dài như cấu trúc dưới đây. Bạn lưu ý bảo mật tuyệt đối các thông tin này và không chia sẻ cho bất kỳ ai khác.
1local consumer_key "xWNlx*N9vESv0ZZBtGdm7fVB"
2local consumer_secret "7D25oVzWeDCHrUlQcp9929@GOcnqWCuUKhDel"
3local access_token "74741598400768-3hAYpZbiDvABPizx5lk57B8CTVyfa"
4local access_token_secret "7HjDf25oVzDWAeDCHrUlQcpfNGOTzcnqWCuUKhDel"
Khởi tạo quyền truy cập và chạy thử nghiệm trong Stata
Trước khi thực hiện bất kỳ lệnh tìm kiếm dữ liệu nào trong mỗi phiên làm việc mới với Stata, bạn bắt buộc phải chạy lệnh khai báo quyền truy cập bằng các mã khóa đã lưu. Nếu bạn quên bước khai báo này, Stata sẽ trả về thông báo lỗi hệ thống.
1. twitter2stata searchtweets "star wars", numtweets(10)
2access token and access token secret not set.
3Run
4twitter2stata setaccess
5to set your access token and access token secret.
6r(198);
Để quá trình vận hành diễn ra trơn tru, một cấu trúc hoàn chỉnh của tệp lệnh do-file chứa cả phần khai báo xác thực lẫn phần tìm kiếm dữ liệu thực tế sẽ được trình bày như sau.
1local consumer_key "xWNlx*N9vESv0ZZBtGdm7fVB"
2local consumer_secret "7D25oVzWeDCHrUlQcp9929@GOcnqWCuUKhDel"
3local access_token "74741598400768-3hAYpZbiDvABPizx5lk57B8CTVyfa"
4local access_token_secret "7HjDf25oVzDWAeDCHrUlQcpfNGOTzcnqWCuUKhDel"
5twitter2stata setaccess "`consumer_key'" "`consumer_secret'" ///
6     "`access_token'" "`access_token_secret'"
7twitter2stata searchtweets "star wars", numtweets(10)
8list user_screen_name user_follower_count user_friend_count, abbreviate(20)
Khi bạn tiến hành khởi chạy tệp lệnh trên, Stata sẽ tự động gửi yêu cầu kết nối đến máy chủ của Twitter, tải về mười bài viết mẫu và hiển thị kết quả trực quan ngay lập tức dưới dạng bảng dữ liệu có cấu trúc.
1. twitter2stata searchtweets "star wars", numtweets(10)
2(45 vars, 10 obs)
3. list user_screen_name user_follower_count user_friend_count, abbreviate(20)
4+------------------------------------------------------------+
5     | user_screen_name   user_follower_count   user_friend_count |
6     |------------------------------------------------------------|
7  1. |            024AB                  1297                1077 |
8  2. |     StarWarsTime                  2040                1213 |
9  3. |      LockerGnome                 24577                 976 |
10  4. |           CMG_HD                     8                  35 |
11  5. |   dilnyminic1986                     4                  30 |
12     |------------------------------------------------------------|
13  6. |     StarWarsTime                  2040                1213 |
14  7. |   emimsohood1975                     3                   8 |
15  8. |  Dan_NinjaRabbit                   712                2252 |
16  9. |  KatelynLunsford                    13                  38 |
17 10. |        PudseyMac                   335                 444 |
18     +------------------------------------------------------------+
Lưu ý về giới hạn tần suất gọi API
Một điểm cực kỳ quan trọng cần ghi nhớ khi làm việc với dữ liệu mạng xã hội đó là các quy định về giới hạn lưu lượng tải. Mỗi câu lệnh con của công cụ này đều bị kiểm soát bởi một định mức truy cập riêng biệt do Twitter thiết lập cho mỗi chu kỳ mười lăm phút. Bạn nên tìm hiểu kỹ bảng quy định giới hạn tần suất gọi API của hệ thống trước khi xây dựng các kịch bản thu thập dữ liệu tự động với quy mô lớn nhằm tránh việc tài khoản ứng dụng bị tạm khóa do vượt quá định mức cho phép.
✨ Khả năng tích hợp linh hoạt giữa ngôn ngữ Java và nền tảng Stata không chỉ giúp mở rộng giới hạn phân tích số liệu truyền thống mà còn mang lại giải pháp thu thập trực tiếp nguồn dữ liệu mạng xã hội khổng lồ về máy tính của bạn chỉ bằng vài dòng lệnh đơn giản.
Câu hỏi tư duy và bài tập thực hành:
Giả sử bạn đang thực hiện một đề tài nghiên cứu thị trường về sự quan tâm của cộng đồng đối với lĩnh vực trí tuệ nhân tạo. Hãy viết một đoạn mã ngắn trong tệp lệnh do-file để thực hiện tìm kiếm mười bài viết gần nhất chứa từ khóa trí tuệ nhân tạo, sau đó sử dụng lệnh hiển thị danh sách của Stata để kiểm tra tên người dùng và số lượng người theo dõi của họ. Bạn có nhận xét gì về mối liên hệ giữa mức độ phổ biến của tài khoản và tần suất đăng bài về chủ đề này không?