Trong hành trình học hỏi về khoa học dữ liệu, có những khái niệm như thể được khắc sâu vào trí nhớ — cho đến khi bạn bất ngờ quên sạch. Nhưng rồi, khi quay lại đọc lại những dòng viết cũ, một “rãnh” nhỏ lại được khơi lại, giúp ta trôi theo dòng chảy kiến thức một cách nhẹ nhàng. Có lẽ chính vì thế mà người ta mới nói “get back in the groove” — không phải vì nhạc funk, mà vì sự trôi chảy của tư duy đã từng tồn tại.
Một trong những khái niệm như thế là Gaussian Process (GP) — một công cụ mạnh mẽ trong học thống kê, đặc biệt khi đối mặt với hàm mục tiêu bí ẩn, đắt đỏ để đánh giá. Hôm nay, chúng ta sẽ cùng nhau hồi sinh lại khái niệm này, đi sâu hơn một bước vào lĩnh vực tối ưu hóa Bayes (Bayesian Optimisation) — nơi GP không chỉ mô hình hóa hàm số, mà còn lên kế hoạch cho những bước tiếp theo.
Chúng ta sẽ dùng R như vũ khí chính, cùng với Stan để triển khai mô hình Bayes chính xác, và một chút code để chứng minh rằng, dù hàm là bí ẩn, ta vẫn có thể tìm ra hướng đi thông minh.
Vấn đề: Hàm Mê Cung Đắt Giá
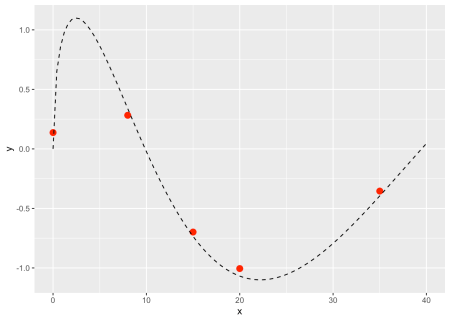
Giả sử bạn có một hàm số mystery_function — liên tục, thực, và cực kỳ bí ẩn — nhưng mỗi lần đánh giá nó đều tốn kém: có thể là chi phí API, tiền token, hay thuế suất. Bạn không thể thử từng điểm một, vì điều đó quá tốn kém.
1mystery_function <- function(x) {
2  cost(dollars = 100)
3  1.1 * sin(sqrt(x))
4}
Bạn chỉ có một vài điểm quan sát, bị nhiễu nhẹ:
1domain <- c(0, 40)
2
3observations <- tibble(x = c(0, 8, 15, 20, 35)) |>
4  mutate(
5    y = mystery_function(x) + rnorm(length(x), mean = 0, sd = 0.1),
6  )
Hình ảnh dữ liệu cho thấy một hàm sóng, nhưng rõ ràng không dễ dàng mô hình hóa bằng hồi quy tuyến tính hay đa thức nếu bạn không biết dạng hàm.
Tại Sao Chọn Gaussian Process?
Hồi quy tuyến tính hay đa thức đều giả định trước dạng hàm. Nhưng GP lại khác: nó là mô hình phi tham số (non-parametric) — không cần biết trước hàm có dạng gì. Thay vào đó, GP xem xét toàn bộ không gian các hàm có thể, và đưa ra phân bố xác suất cho từng điểm.
Lý do thứ hai: GP cung cấp độ bất định (uncertainty) một cách tự nhiên. Không chỉ dự đoán giá trị trung bình, mà còn cho biết ta tin tưởng đến đâu vào dự đoán đó — điều cực kỳ quan trọng khi quyết định điểm tiếp theo để đo.
Làm Thế Nào Một Mô Hình “Tạo Ra” Hàm?
Một GP là một phân phối xác suất trên tập hợp các hàm liên tục. Mỗi lần lấy mẫu từ nó, bạn nhận được một đường cong ngẫu nhiên.
1# Tạo một hàm ngẫu nhiên từ phân phối đa biến chuẩn
2n.dims <- 16
3sigma <- diag(n.dims)  # Không tương quan giữa các điểm
4
5random.draw <- MASS::mvrnorm(n = 1, mu = rep(0, n.dims), Sigma = sigma)
6
7ggplot(data.frame(x = 1:n.dims, y = random.draw)) +
8  aes(x = x, y = y) +
9  geom_line()
Nhưng nếu bạn muốn các hàm trông giống như thực tế — trơn tru, liên tục — bạn cần một hàm nhân (kernel) tốt hơn. Thường dùng là hàm nhân bình phương mũ (squared exponential kernel), điều chỉnh bởi hai tham số: alpha (biên độ) và lambda (tần số).
1sq_exp_cov <- function(x, lambda, alpha) {
2  n <- length(x)
3  K <- matrix(0, n, n)
4  for (i in 1:n) {
5    for (j in 1:n) {
6      diff <- sqrt(sum((x[i] - x[j])^2))
7      K[i, j] <- alpha^2 * exp(-diff^2 / (2 * lambda^2))
8    }
9  }
10  K
11}
Với kernel này, ta có thể tạo ra nhiều hàm mẫu:
1plot_random_gp <- function(lambda, alpha) {
2  n.samples <- 5
3  x <- seq(0, 9, 0.1)
4  samples <- MASS::mvrnorm(
5    n = n.samples,
6    mu = rep(0, length(x)),
7    Sigma = sq_exp_cov(x, lambda = lambda, alpha = alpha)
8  )
9
10  t(samples) |> as_tibble() |>
11    mutate(x = x) |>
12    pivot_longer(-x, names_to = "sample", values_to = "y") |>
13    ggplot() +
14    aes(x = x, y = y, group = sample, colour = sample) +
15    geom_line()
16}
17
18plot_random_gp(lambda = 2, alpha = 1)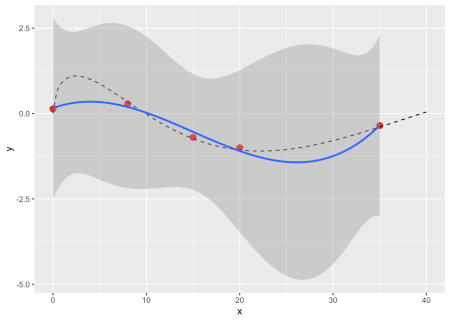
Những đường cong này cho thấy sự linh hoạt: chúng trơn tru, có thể lồi, lõm, nhưng vẫn hợp lý về mặt toán học. Đây chính là "hệ thống đề xuất hàm" của GP.
Mô Hình Bayes với Stan: Khi Mô Hình Biết “Cảm Nhận” Dữ Liệu
Chúng ta sẽ dùng Stan để ước lượng phân bố hậu nghiệm của hàm số — tức là, xác định các hàm khả dĩ đã được điều chỉnh phù hợp với dữ liệu quan sát.
1// gp-cholesky.stan (tối ưu hóa bằng phân tích Cholesky)
2data {
3  int n_obs;
4  array[n_obs] real x_obs;
5  array[n_obs] real y_obs;
6  real<lower=0> sigma;
7  int n_pred;
8  array[n_pred] real x_pred;
9  real alpha;
10  real lambda;
11}
12transformed data {
13  int n = n_obs + n_pred;
14  array[n] real x;
15  x[1:n_obs] = x_obs;
16  x[(n_obs+1):n] = x_pred;
17
18  matrix[n, n] K = gp_exp_quad_cov(x, alpha, lambda);
19  for (i in 1:n) K[i, i] += 1e-6;
20}
21parameters {
22  vector[n] f_x;
23}
24model {
25  f_x ~ multi_normal(rep_vector(0, n), K);
26  y_obs ~ normal(f_x[1:n_obs], sigma);
27}
Chạy mô hình:
1x.pred <- seq(domain[1], domain[2], by = 0.25)
2x.vals <- c(observations$x, x.pred)
3
4model <- cmdstan_model(stan_file = "gp-cholesky.stan", exe = "gp.stan.bin")
5sample <- model$sample(
6  seed = SEED,
7  list(
8    n_data = nrow(observations),
9    x_data = as.array(observations$x),
10    y_data = as.array(observations$y),
11    sigma = 0.2,
12    n_pred = length(x.pred),
13    x_pred = x.pred,
14    alpha = 1,
15    lambda = 2
16  ),
17  parallel_chains = 4,
18  max_treedepth = 20,
19  show_messages = FALSE
20)
Sau khi kiểm tra rhat và ess (đều ổn định), ta có thể trích xuất các mẫu để trực quan hóa:
1tidy_sample <- function(sample) {
2  mat <- sample$draws(format = "draws_matrix")
3  as_tibble(mat) |>
4    mutate(draw = 1:n()) |>
5    pivot_longer(starts_with("f"), names_to = "x", values_to = "y") |>
6    mutate(
7      idx = as.numeric(str_extract(x, "[0-9]+")),
8      x = x.vals[idx],
9      y = as.numeric(y)
10    )
11}
12
13plot_draws <- function(sample) {
14  draws <- tidy_sample(sample)
15  ggplot(observations) +
16    aes(x = x, y = y) +
17    geom_line(
18      data = draws,
19      mapping = aes(group = draw),
20      alpha = 0.01,
21      colour = "darkgreen"
22    ) +
23    geom_point(colour = "red", size = 3) +
24    geom_function(fun = mystery_function, colour = "black", linetype = "dashed")
25}
26
27plot_draws(sample)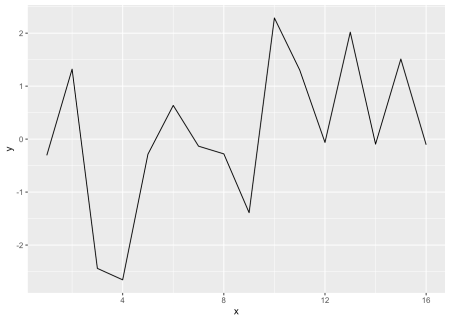
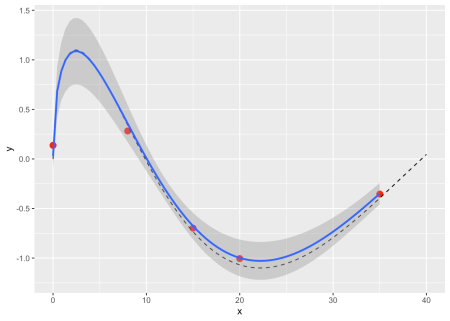
Hình ảnh này giống như một đồng hồ Noel: hàng trăm đường cong mờ ảo, bao quanh các điểm quan sát, thể hiện rõ ràng: ta chắc chắn hơn ở gần dữ liệu, và rất bất định ở các vùng xa.
Tối Ưu Hóa Bayes: Lựa Chọn Điểm Tiếp Theo
Bây giờ tới phần thú vị: tìm điểm tiếp theo để đo — không để ngẫu nhiên, mà để tối ưu hóa khả năng tìm thấy cực đại.
Ở đây, ta dùng chức năng thu hút (acquisition function), và phổ biến nhất là Expected Improvement (EI).
Expected Improvement là trung bình của phần cải thiện dự kiến so với giá trị tốt nhất hiện tại — nhưng chỉ tính khi cải thiện là dương.
1y.best <- max(observations$y)
2
3expected_improvement <- function(sample, x.vals, y.best) {
4  mat <- sample$draws(format = "draws_matrix")
5  mat <- mat[, str_starts(colnames(mat), "f")]
6  mat <- t(mat)
7
8  n.points <- nrow(mat)
9  ei <- numeric(length = n.points)
10
11  for (i in 1:n.points) {
12    samples <- mat[i, ]
13    improvements <- pmax(0, samples - y.best)
14    ei[i] <- mean(improvements)
15  }
16
17  x.vals[which.max(ei)]
18}
19
20x.next <- expected_improvement(sample, x.vals, y.best)
21sprintf("Next x: %.2f", x.next)1[1] "Next x: 5.00"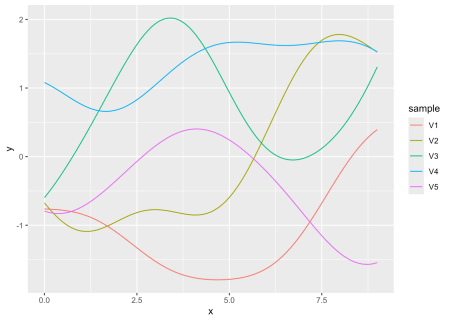
Chưa đầy 5 phút, GP đã gợi ý: điểm x = 5.00 là nơi tốt nhất để đo tiếp. Và thực tế, cực đại lý thuyết của hàm nằm khoảng x ≈ 2.47, nên điểm này là bước đi hợp lý — nằm trong vùng có thể tìm thấy giá trị lớn hơn.
Tối Ưu Hóa Bayes: Một Chuỗi Quyết Đinh Thông Minh
Công việc không dừng lại ở đây. Bạn đo tại x = 5, cập nhật dữ liệu, chạy lại GP, và lại chọn điểm tiếp theo. Lặp lại quá trình này — một chuỗi học hỏi — dự đoán — hành động — học hỏi lại.
Đây chính là cốt lõi của tối ưu hóa Bayes (Bayesian Optimisation):
- Xây dựng mô hình GP từ dữ liệu hiện có.
- Tính toán hàm thu hút (acquisition) để xác định điểm tốt nhất để đo.
- Đo tại điểm đó, bổ sung dữ liệu.
- Lặp lại.
Trong R, bạn có thể dùng tune_bayes từ tune package để làm điều này một cách tự động — không cần code từ đầu.
✨ Giá trị đắt giá:
Không chỉ tìm được cực đại, Gaussian Process còn cho bạn bản đồ độ tin cậy — nơi bạn tự tin, nơi bạn phải cẩn trọng. Trong thế giới thực, nơi mỗi phép đo tốn kém, điều này là vô giá.
🧠 Bài tập tư duy:
Giả sử bạn đang tối ưu hóa hàm chi phí của một mô hình học máy, với mỗi đánh giá tốn 1 giờ tính toán. Bạn có 10 lần đánh giá còn lại. Hãy thiết kế một chiến lược sử dụng GP và Expected Improvement để tối đa hóa khả năng tìm ra giá trị nhỏ nhất. Mô tả cách bạn sẽ chọn điểm tiếp theo, và làm thế nào để kiểm tra hiệu quả trong trường hợp thực.