Gói deltatest vừa phát hành phiên bản 0.2.0 với hai cập nhật quan trọng: phương thức tidy() cho đối tượng deltatest và sửa lỗi tính giá trị p cho kiểm định một phía. Trước khi đi vào chi tiết, hãy nhắc lại nhanh mục đích của gói này.
deltatest giải quyết bài toán gì
deltatest cung cấp hàm deltatest() để thực hiện kiểm định Z hai mẫu dựa trên phương pháp Delta. Gói này thiết kế cho bối cảnh phổ biến trong thử nghiệm A/B trực tuyến: ngẫu nhiên hóa ở mức người dùng nhưng chỉ số đo lường ở đơn vị tốt hơn như lượt xem trang hoặc phiên làm việc.
Trong thiết lập này, các kiểm định ngây thơ (Z-test chuẩn, kiểm định chi-bình phương, kiểm định hiệu tỷ lệ) thường thấp 추정 độ không chắc chắn vì các quan sát trong cùng một người dùng không độc lập. deltatest() khắc phục vấn đề này bằng bộ ước lượng phương sai dựa trên phương pháp Delta.
Cài đặt và chạy nhanh:
1# Cài phiên bản CRAN
2install.packages("deltatest")
3
4# Nạp gói
5library(dplyr)
6library(deltatest)
7
8# Tạo dữ liệu giả
9data <- deltatest::generate_dummy_data(2000) |>
10  mutate(group = if_else(group == 0, "control", "treatment")) |>
11  group_by(user_id, group) |>
12  summarise(clicks = sum(metric), pageviews = n(), .groups = "drop")
13
14# Chạy kiểm định
15deltatest(data, clicks / pageviews, by = group)
Kết quả điển hình:
1#> Two Sample Z-test Using the Delta Method
2#>
3#> data:  clicks/pageviews by group
4#> Z = 0.31437, p-value = 0.7532
5#> alternative hypothesis: true difference in means between control and treatment is not equal to 0
6#> 95 percent confidence interval:
7#>  -0.01410593  0.01949536
8#> sample estimates:
9#>   mean in control mean in treatment        difference
10#>       0.245959325       0.248654038       0.002694713
Tính năng mới trong 0.2.0
Hỗ trợ tidy() cho đối tượng deltatest
Phiên bản này cho phép chuyển kết quả deltatest() trực tiếp thành tibble gọn gàng nhờ broom::tidy(). Đối tượng trả về lớp htest tiện cho in ra và dùng tương tác, nhưng trong quy trình tidyverse, định dạng tibble dễ dàng hơn cho việc gộp kết quả nhiều thử nghiệm hoặc chỉ số, cũng như trực quan hóa ước lượng, khoảng tin cậy, giá trị p bằng ggplot2.
Ví dụ chuyển đổi đơn giản:
1library(dplyr)
2library(deltatest)
3library(broom)
4
5data <- deltatest::generate_dummy_data(2000) |>
6  mutate(group = if_else(group == 0, "control", "treatment")) |>
7  group_by(user_id, group) |>
8  summarise(clicks = sum(metric), pageviews = n(), .groups = "drop")
9
10result <- deltatest(data, clicks / pageviews, by = group)
11
12tidy(result)
13#> # A tibble: 1 × 9
14#>   estimate mean_ctrl mean_treat statistic p.value conf.low conf.high method
15#>      <dbl>     <dbl>      <dbl>     <dbl>   <dbl>    <dbl>     <dbl> <chr>
16#> 1  0.00269     0.246      0.249     0.314   0.753  -0.0141    0.0195 Two Sample…
17#> # ℹ 1 more variable: alternative <chr>
Tiếp theo, ví dụ dùng kết quả tidy để so sánh nhiều thử nghiệm trên biểu đồ:
1library(ggplot2)
2
3data2 <- deltatest::generate_dummy_data(2000, xi = 0.05) |>
4  mutate(group = if_else(group == 0, "control", "treatment")) |>
5  group_by(user_id, group) |>
6  summarise(clicks = sum(metric), pageviews = n(), .groups = "drop")
7
8result2 <- deltatest(data2, clicks / pageviews, by = group)
9
10result_tidy1 <- tidy(result)  |> mutate(experiment_id = "test01")
11result_tidy2 <- tidy(result2) |> mutate(experiment_id = "test02")
12
13result_tidy <- bind_rows(result_tidy1, result_tidy2)
14
15ggplot(result_tidy, aes(experiment_id, estimate)) +
16  geom_pointrange(aes(ymin = conf.low, ymax = conf.high)) +
17  geom_hline(yintercept = 0, color = "red") +
18  xlab(NULL) + ylab("Estimated CTR difference") +
19  ggtitle("Treatment effects by experiment")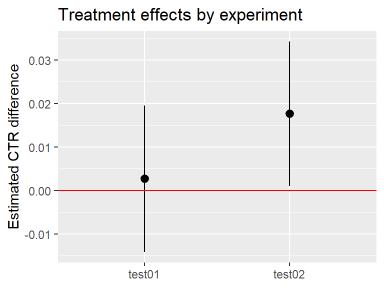
Sửa lỗi tính giá trị p cho kiểm định một phía
Phát hành này cũng khắc phục lỗi tính giá trị p cho kiểm định một phía. Phiên bản trước có thể tính sai giá trị p một phía bằng công thức hai phía. Hành vi này đã được sửa chính xác.
Tác giả xin cảm ơn Kazuyuki Sano đã báo cáo vấn đề và đóng góp bản sửa.
Lời kết
Tác giả vui mừng hoàn thiện deltatest từng chút một. Nếu bạn dùng R cho thử nghiệm A/B trực tuyến, hy vọng gói này hữu ích.
Tham khảo thêm:
- Trang gói: https://hoxo-m.github.io/deltatest/
- Kho GitHub: https://github.com/hoxo-m/deltatest
✨ Giá trị đắt giá: Việc tích hợp broom::tidy() biến kết quả kiểm định phức tạp thành bảng dữ liệu chuẩn, cho phép bạn xử lý hàng chục chỉ số thử nghiệm cùng lúc chỉ bằng vài dòng dplyr và ggplot2 — một bước tiến lớn cho quy trình phân tích tự động hóa.
Câu hỏi tư duy: Khi so sánh tỷ lệ nhấp (CTR) giữa hai nhóm trong A/B test, tại sao việc bỏ qua sự phụ thuộc giữa các phiên của cùng một người dùng lại dẫn đến kết quả quá lạc quan (giá trị p nhỏ hơn thực tế)? Hãy thử mô phỏng dữ liệu có tương quan nội người dùng cao và so sánh kết quả deltatest() với prop.test() để quan sát sự khác biệt.