Dữ liệu hiện diện ở khắp mọi nơi trong kỷ nguyên số. Rất nhiều cơ quan chính phủ, tổ chức tài chính, trường đại học và nền tảng mạng xã hội cung cấp quyền truy cập vào kho dữ liệu của họ thông qua giao diện lập trình ứng dụng API. Các API này thường phản hồi và trả về dữ liệu dưới định dạng JSON. Trong bài viết này, chúng ta sẽ cùng khám phá cách tận dụng sức mạnh của Python ngay bên trong Stata để gửi yêu cầu truy xuất dữ liệu qua API, bóc tách cấu trúc dữ liệu JSON lồng nhau và chuyển đổi thành tập dữ liệu Stata sẵn sàng cho phân tích.
Tìm hiểu về API và cấu trúc dữ liệu JSON
Một API cho phép hệ thống này yêu cầu và nhận dữ liệu từ một hệ thống máy tính khác. Cú pháp của mỗi API có thể khác biệt tùy theo nhà cung cấp, nhưng thông thường cấu trúc truy vấn sẽ bao gồm một đường dẫn URL gốc đi kèm các tham số điều kiện.
Chẳng hạn, đường dẫn dưới đây sử dụng openFDA API để truy xuất thông tin về các biến cố bất lợi của thuốc từ Cục Quản lý Thực phẩm và Dược phẩm Hoa Kỳ:
1https://api.fda.gov/drug/event.json?Chúng ta có thể thêm các tùy chọn để thu hẹp phạm vi tìm kiếm. Ví dụ, để đếm số lượng biến cố bất lợi liên quan đến thuốc Fentanyl tại Hoa Kỳ trong giai đoạn từ ngày 01 tháng 01 năm 2018 đến ngày 05 tháng 01 năm 2018, đường dẫn sẽ được mở rộng như sau:
1https://api.fda.gov/drug/event.json?search=receivedate[20180101+TO+20180105]+AND+occurcountry:"US"+AND+patient.drug.openfda.brand_name:"Fentanyl"&count=receivedateKhi nhập URL này vào trình duyệt web, kết quả trả về sẽ là một tệp dữ liệu định dạng JSON. JSON lưu trữ thông tin dưới dạng các cặp khóa và giá trị. Trong đó, khóa tương tự như tên biến trong Stata, còn giá trị chính là dữ liệu thực tế. Dữ liệu JSON thường có cấu trúc phân tầng phức tạp, các cặp khóa giá trị có thể nằm lồng bên trong những khóa cấp cao hơn như meta và results.
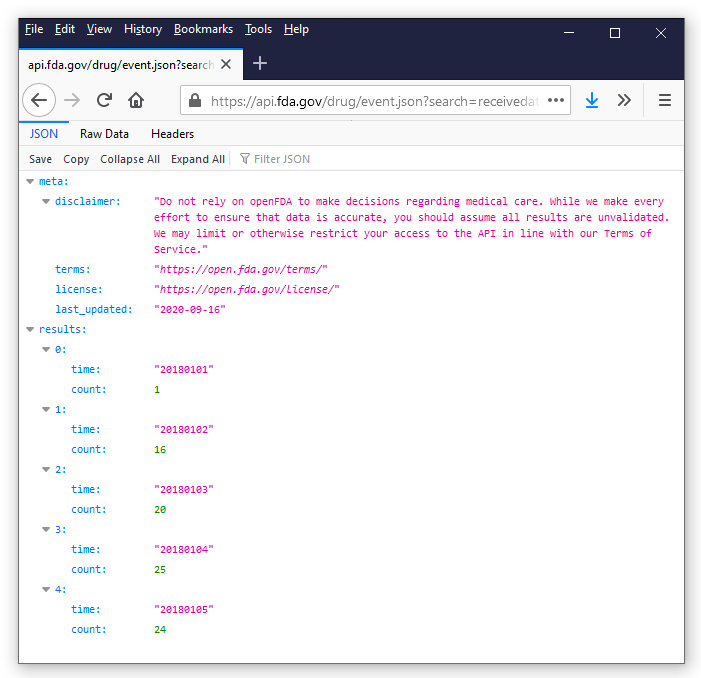
Mục tiêu của chúng ta là gửi yêu cầu đến openFDA API, xử lý tệp JSON phân tầng này và lưu lại dưới dạng một tập dữ liệu Stata hoàn chỉnh. Trước khi bắt đầu, hãy đảm bảo rằng môi trường Python của bạn đã cài đặt hai thư viện là requests và pandas.
Xây dựng đường dẫn truy vấn API bằng Python
Để mã lệnh dễ đọc và dễ bảo trì, chúng ta không nên viết toàn bộ URL dài vào một dòng đơn lẻ. Thay vào đó, hãy chia nhỏ các thành phần tìm kiếm thành từng chuỗi ký tự riêng biệt rồi ghép nối lại với nhau trong khối lệnh Python.
1API     = 'https://api.fda.gov/drug/event.json?search='
2date    = 'receivedate:[20180101+TO+20180105]'
3country = 'occurcountry:"US"'
4drug    = 'patient.drug.openfda.brand_name:"Fentanyl"'
5data    = 'count=receivedate'
6URL     = API + date + "+AND+" + country + "+AND+" + drug + "&" + data
7URL
Cách tiếp cận mô-đun hóa này giúp cú pháp luôn rõ ràng ngay cả khi bạn cần bổ sung thêm nhiều điều kiện lọc phức tạp về thời gian, địa lý hay tên loại thuốc.
Gửi yêu cầu và trích xuất dữ liệu JSON
Sau khi đã tạo xong đường dẫn truy vấn, chúng ta sử dụng thư viện requests để gửi yêu cầu đến máy chủ openFDA và chuyển kết quả nhận được sang định dạng từ điển trong Python bằng phương thức json.
1import requests
2import json
3API     = 'https://api.fda.gov/drug/event.json?search='
4date    = 'receivedate:[20180101+TO+20180105]'
5country = 'occurcountry:"US"'
6drug    = 'patient.drug.openfda.brand_name:"Fentanyl"'
7data    = 'count=receivedate'
8URL     = API + date + "+AND+" + country + "+AND+" + drug + "&" + data
9data    = requests.get(URL).json()
10print(json.dumps(data, indent=4, sort_keys=True))
Khi in dữ liệu bằng phương thức dumps với tùy chọn thụt đầu dòng, cấu trúc phân cấp sẽ hiện ra rõ nét. Đối tượng dữ liệu bao gồm hai khóa chính là meta chứa thông tin bản quyền, điều khoản sử dụng và results chứa số liệu thực tế về các trường hợp biến cố theo ngày. Vì chỉ cần dữ liệu định lượng phục vụ nghiên cứu, chúng ta sẽ bóc tách riêng phần results vào một danh sách.
1fdadata = data.get('results', [])
2print(json.dumps(fdadata, indent=4, sort_keys=True))
Chuyển đổi dữ liệu JSON thành tập dữ liệu Stata
Dữ liệu trong danh sách fdadata vẫn ở dạng các cặp khóa giá trị. Để biến đổi cấu trúc này thành dạng hàng và cột quen thuộc, chúng ta sử dụng thư viện pandas để nạp dữ liệu vào một data frame.
1import pandas as pd
2fda_df = pd.read_json(json.dumps(fdadata))
3fda_df
Kết quả data frame thu được gồm các cột: chỉ số dòng, thời gian xảy ra biến cố và số lượng ca ghi nhận. Bước cuối cùng trong Python là xuất bảng dữ liệu này sang tệp định dạng Stata bằng phương thức to_stata.
1fda_df.to_stata('fentanyl.dta', version=118)Bây giờ bạn có thể quay trở lại môi trường Stata thông thường để mở và kiểm tra tệp dữ liệu vừa tạo.
1use fentanyl.dta, clear
2list
Mở rộng phạm vi dữ liệu và trực quan hóa trong Stata
Khi quy trình đã hoạt động trơn tru, bạn có thể dễ dàng mở rộng khung thời gian tìm kiếm từ năm 2010 đến năm 2020 để phân tích xu hướng dài hạn. Dưới đây là toàn bộ đoạn mã hoàn chỉnh kết hợp giữa thu thập dữ liệu bằng Python và xử lý, vẽ đồ thị chuỗi thời gian trong Stata:
1python:
2import requests
3import json
4import pandas as pd
5API     = 'https://api.fda.gov/drug/event.json?search='
6date    = 'receivedate:[20100101+TO+20200101]'
7country = 'occurcountry:"US"'
8drug    = 'patient.drug.openfda.brand_name:"Fentanyl"'
9data    = 'count=receivedate'
10URL     = API + date + "+AND+" + country + "+AND+" + drug + "&" + data
11data    = requests.get(URL).json()
12fdadata = data.get('results', [])
13fda_df  = pd.read_json(json.dumps(fdadata))
14fda_df.to_stata('fentanyl.dta', version=118)
use fentanyl.dta, clear
drop index
generate date = mofd(date(string(time, "%8.0f"),"YMD"))
format date %tm
collapse (sum) count, by(date)
tsset date, monthly
twoway (line count date, lcolor(blue) lwidth(medthick)), ///
ytitle("So ca bien co bao cao ve FDA") ///
ylabel(0(2000)8000, angle(horizontal) grid) ///
xtitle("") ///
title("Bien co bat loi lien quan den Fentanyl bao cao ve FDA") ///
caption(Nguon du lieu: openFDA, size(small)) ///
scheme(s1color)
end
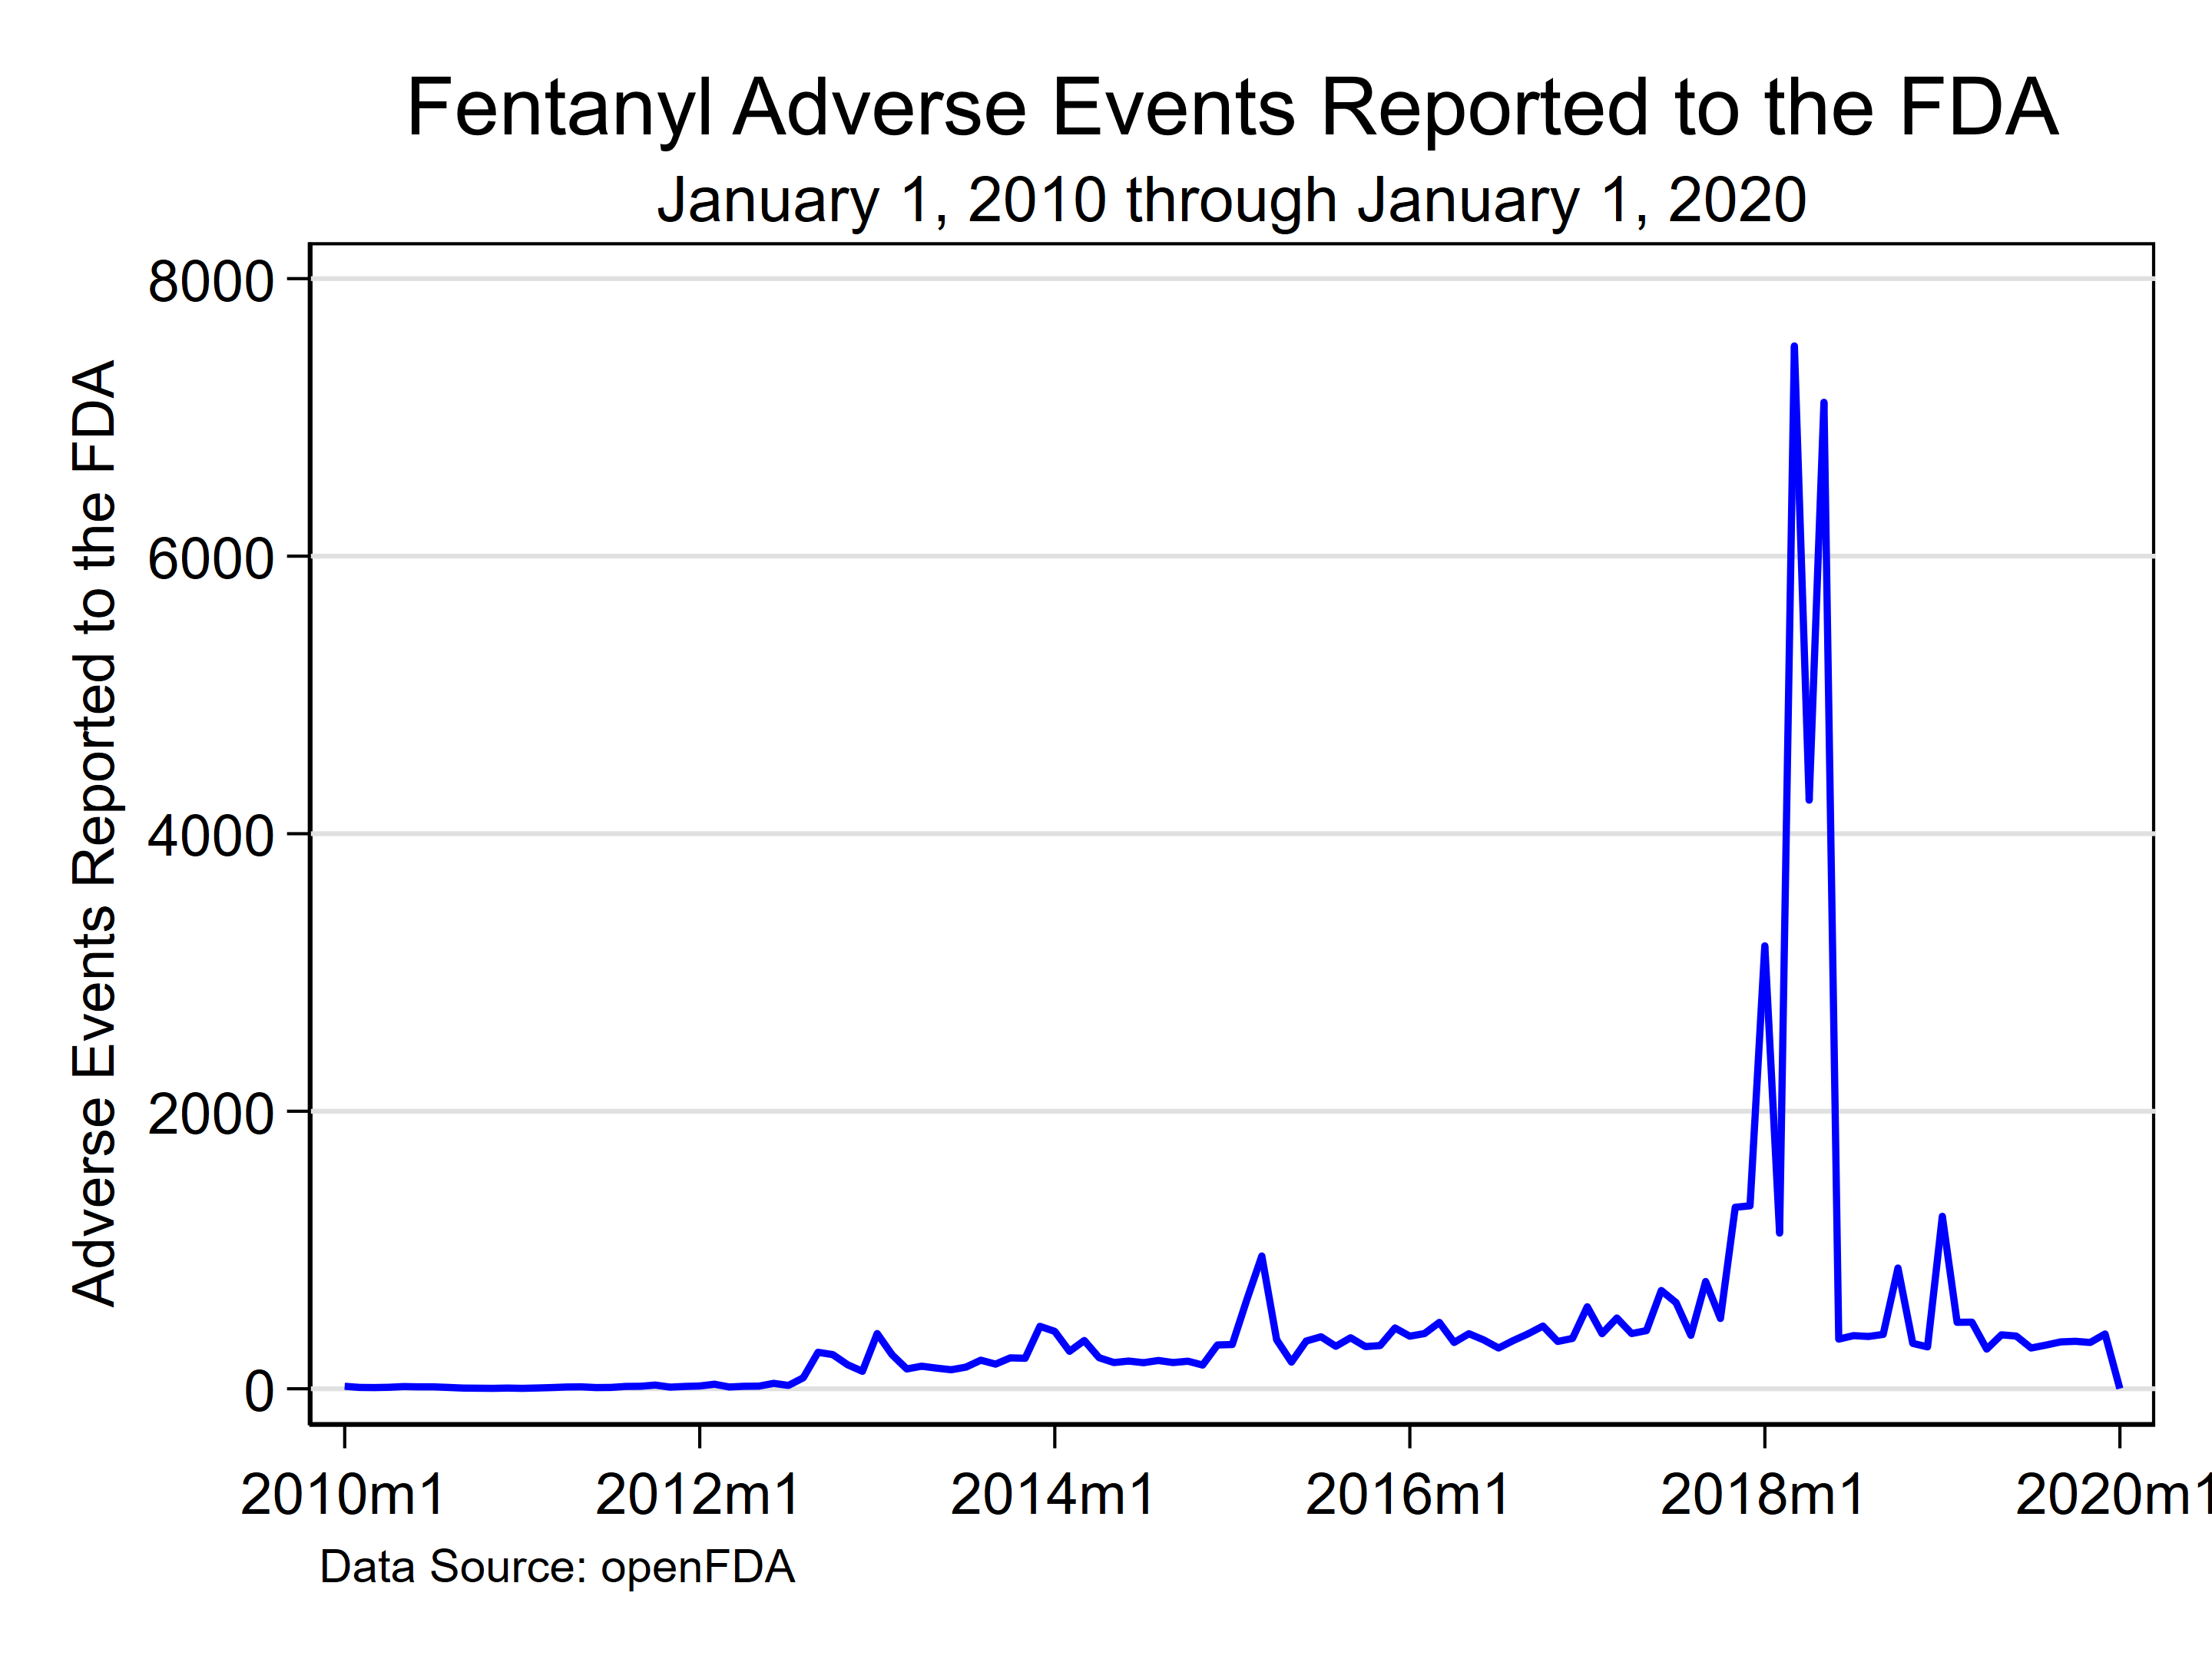
✨ Điểm đắt giá nhất của kỹ thuật này nằm ở việc xóa bỏ hoàn toàn ranh giới giữa bước thu thập dữ liệu trực tuyến và phân tích định lượng. Bạn không còn phải tải tệp thủ công qua giao diện web rồi nhập liệu phức tạp. Toàn bộ quy trình từ gửi truy vấn API, chuẩn hóa cấu trúc lồng nhau của JSON cho đến ước lượng thống kê và trực quan hóa đều được tự động hóa mượt mà chỉ trong một tệp lệnh Stata duy nhất.
Câu hỏi tư duy và bài tập ứng dụng:
Bạn có thể áp dụng quy trình này để lấy dữ liệu về một loại dược phẩm khác từ openFDA hoặc kết nối tới một API mở của Ngân hàng Thế giới không? Trong trường hợp dữ liệu JSON trả về có cấu trúc phân tầng nhiều cấp sâu hơn, bạn sẽ sử dụng phương thức nào của thư viện pandas để làm phẳng dữ liệu trước khi chuyển sang Stata?