Trong bài viết trước, chúng ta đã tìm hiểu cách cài đặt các thư viện Python bằng pip. Hôm nay, chúng ta sẽ đi sâu vào những thao tác cơ bản nhất để nạp và sử dụng các thư viện này ngay trong môi trường Stata. Thông qua các ví dụ thực hành với thư viện pandas, bài viết sẽ giúp bạn nắm vững những khái niệm quan trọng cùng cú pháp cốt lõi có thể áp dụng cho hầu hết thư viện Python hiện nay.
Kiểm tra và nạp thư viện Python
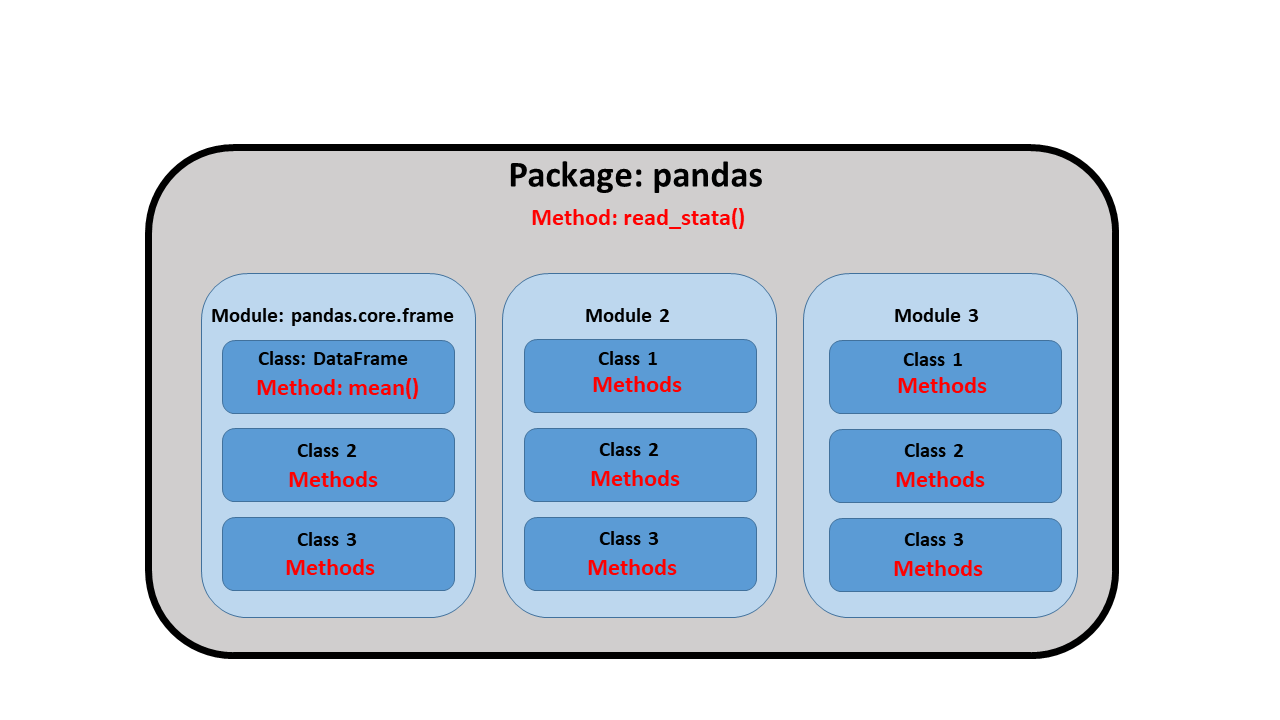
Thư viện pandas là một công cụ rất phổ biến dùng để xử lý, nhập và xuất dữ liệu trong Python. Thư viện này chứa nhiều module khác nhau phục vụ công việc tương tác với các cấu trúc dữ liệu như series hay data frame.
Trước tiên, bạn có thể kiểm tra xem pandas đã được cài đặt trên hệ thống hay chưa bằng câu lệnh sau trong Stata:
1python which pandasNếu kết quả hiển thị đường dẫn tệp tin, điều đó có nghĩa là thư viện đã sẵn sàng. Để thông báo cho Python biết bạn muốn sử dụng pandas, hãy dùng câu lệnh import ngay đầu khối mã lệnh.
1import pandasSau khi nạp thư viện, chúng ta có thể đọc tập dữ liệu mẫu từ máy chủ Stata Press vào một data frame có tên là auto thông qua phương thức read_stata.
1import pandas
2auto = pandas.read_stata("http://www.stata-press.com/data/r16/auto.dta")
Thuật ngữ method được dùng để chỉ một hàm nằm bên trong một module hoặc class. Ở đây, read_stata là hàm có nhiệm vụ chuyển đổi dữ liệu Stata sang dạng data frame của pandas.
Rút gọn tên thư viện bằng bí danh
Khi làm việc thực tế, thư viện pandas chứa rất nhiều phương thức khác nhau. Việc phải gõ lại tên thư viện trước mỗi phương thức có thể làm mã nguồn trở nên dài dòng. Để tối ưu hóa, bạn có thể gán một bí danh ngắn gọn khi nạp thư viện bằng từ khóa as.
Chẳng hạn, thay vì viết đầy đủ tên thư viện, chúng ta thường quy ước đặt bí danh là pd.
1import pandas as pd
2auto = pd.read_stata("http://www.stata-press.com/data/r16/auto.dta")
Lúc này, câu lệnh gọi phương thức sẽ ngắn gọn hơn rất nhiều mà vẫn đảm bảo tính chính xác.
Sử dụng class và phương thức trong module
Các module giúp chia nhỏ tính năng của thư viện theo từng mục đích sử dụng. Một module có thể chứa các phương thức, class và biến số. Trong thực tế, chúng ta thường gọi trực tiếp các class trong thư viện và bỏ qua tên module trung gian.
Ví dụ, class DataFrame nằm trong module quản lý khung dữ liệu của pandas. Đoạn mã dưới đây sử dụng phương thức mean nằm trong class DataFrame để tính giá trị trung bình cho các biến mpg và weight.
1import pandas as pd
2auto = pd.read_stata("http://www.stata-press.com/data/r16/auto.dta")
3pd.DataFrame.mean(auto[['mpg','weight']])
Kết quả đầu ra sẽ trả về giá trị trung bình của hai biến số cùng với kiểu dữ liệu tương ứng trong Python.
Nạp trực tiếp class hoặc phương thức cụ thể
Nếu muốn mã nguồn gọn gàng hơn nữa, bạn có thể nạp trực tiếp class từ thư viện. Lưu ý rằng Python phân biệt chữ hoa và chữ thường, do đó tên class cần được viết chính xác.
1import pandas as pd
2from pandas import DataFrame
3auto = pd.read_stata("http://www.stata-press.com/data/r16/auto.dta")
4DataFrame.mean(auto[['mpg','weight']])
Bên cạnh đó, bạn cũng có thể gán bí danh cho chính class đó. Việc đặt bí danh cho class giúp thao tác gọi phương thức tính toán trở nên nhanh chóng hơn.
1import pandas as pd
2from pandas import DataFrame as df
3auto = pd.read_stata("http://www.stata-press.com/data/r16/auto.dta")
4df.mean(auto[['mpg','weight']])
Tổng kết các khái niệm
Để hệ thống lại toàn bộ kiến thức, hãy cùng điểm qua các khái niệm nền tảng đã học:
Thư viện Python là một tập hợp gồm nhiều module. Mỗi module chứa các phương thức, class và biến số.
Phương thức là một hàm có khả năng nhận các tham số và thực hiện một tác vụ cụ thể.
Class và module giúp sắp xếp các chức năng theo nhóm logic, đòi hỏi chúng ta phải nạp đúng cấu trúc trước khi gọi lệnh.
✨ Giá trị đắt giá: Việc thành thạo cách nạp module và tạo bí danh trong Python không chỉ giúp mã nguồn Stata của bạn sạch sẽ, chuyên nghiệp hơn mà còn tối ưu hóa tốc độ viết mã khi xử lý các tập dữ liệu lớn. Kỹ năng kết hợp linh hoạt giữa các lệnh Stata thuần túy và hệ sinh thái phong phú của Python sẽ mở ra khả năng phân tích dữ liệu đa chiều mạnh mẽ hơn rất nhiều.
Bài tập ứng dụng: Bạn hãy thử nạp thư viện pandas với bí danh pd, sau đó sử dụng phương thức read_stata để tải một tập dữ liệu Stata bất kỳ và tìm cách nạp riêng class Series để xuất ra mô tả thống kê cơ bản cho một cột dữ liệu duy nhất.