Dự báo các thị trường tài chính, ví dụ như chỉ số STOXX Europe 600, là một thử thách kinh điển trong ngành khoa học dữ liệu. Dữ liệu tài chính vốn dĩ chứa nhiều nhiễu, không dừng và cực kỳ nhạy cảm trước các sự kiện thị trường đột ngột. Để giải quyết vấn đề này, chúng ta có thể áp dụng học máy tự động, cụ thể là khung làm việc hiệu năng cao của H2O kết hợp cùng hệ sinh thái modeltime trong ngôn ngữ R. Bài viết này phân tích chi tiết toàn bộ quy trình vận hành học máy từ khâu thu thập dữ liệu, kỹ nghệ đặc trưng cho đến huấn luyện và đánh giá mô hình thực tế để tìm ra giải pháp tối ưu trước sự biến động của thị trường.
Quy Trình Dự Báo Và Xây Dựng Tập Đặc Trưng
Chiến lược cốt lõi ở đây là chuyển đổi bài toán chuỗi thời gian đơn biến thành bài toán học máy có giám sát bằng cách tạo ra các biến dự báo có giá trị giải thích cao.
Thu thập và phân chia dữ liệu
Mục tiêu dự báo của chúng ta là giá đóng cửa của chỉ số STOXX Europe 600. Dữ liệu được sử dụng kéo dài mười hai tháng và kết thúc vào ngày cuối cùng của tháng mười năm 2025. Quá trình phân chia dữ liệu được thực hiện nghiêm ngặt theo trình tự thời gian lũy kế, trong đó mười lăm ngày cuối cùng được giữ lại để làm tập kiểm thử nhằm mô phỏng chính xác kịch bản kiểm thử ngược ngoài đời thực.
1devtools::install_github("business-science/modeltime.h2o", force = TRUE)
2library(tidymodels)
3library(modeltime.h2o)
4library(tidyverse)
5library(timetk)
6df_stoxx <-
7  tq_get("^STOXX", to = "2025-10-31") %>%
8  select(date, stoxx = close) %>%
9  mutate(id = "id") %>%
10  filter(date >= last(date) - months(12)) %>%
11  drop_na()
12splits <-
13  df_stoxx %>%
14  time_series_split(
15    assess     = "15 days",
16    cumulative = TRUE
17  )
Kỹ nghệ đặc trưng
Một quy trình tiền xử lý dữ liệu mạnh mẽ được thiết kế để nắm bắt cả tính phụ thuộc thời gian và tính mùa vụ của chuỗi số liệu.
Đầu tiên là các biến trễ tự hồi quy để ghi nhận trực tiếp giá trị của một và hai ngày trước đó. Đây là đặc trưng quan trọng nhất để nắm bắt quán tính và đà biến động của thị trường từ các phân tích chẩn đoán trước đó. Tiếp theo, các thành phần Fourier được áp dụng để mô tả các hiệu ứng chu kỳ năm hoặc quý một cách tinh tế. Cuối cùng, các đặc trưng thời gian giúp hệ thống phát hiện các bất thường mang tính lịch biểu như hiệu ứng ngày thứ hai đầu tuần của thị trường tài chính.
1rec_spec <-
2  recipe(stoxx ~ date, data = training(splits)) %>%
3  step_timeseries_signature(date) %>%
4  step_lag(stoxx, lag = 1:2) %>%
5  step_fourier(date, period = 365.25, K = 1) %>%
6  step_dummy(all_nominal_predictors(), one_hot = TRUE) %>%
7  step_zv(all_predictors()) %>%
8  step_naomit(all_predictors())
9train_tbl <-
10  rec_spec %>%
11  prep() %>%
12  bake(training(splits))
13test_tbl  <-
14  rec_spec %>%
15  prep() %>%
16  bake(testing(splits))
Thực Thi H2O AutoML Trong Thời Gian Giới Hạn
Chúng ta bắt đầu khởi chạy quy trình tự động hóa với các ràng buộc tài nguyên nghiêm ngặt để nhanh chóng xác định cấu trúc mô hình hứa hẹn nhất. Thời gian chạy tối đa được đặt ở mức năm giây, số lượng mô hình cơ sở giới hạn ở mức ba và loại bỏ thuật toán học sâu để tối ưu hóa tốc độ thử nghiệm.
1h2o.init(
2  nthreads = -1,
3  ip       = 'localhost',
4  port     = 54321
5)
6model_spec <- automl_reg(mode = 'regression') %>%
7  set_engine(
8    engine                     = 'h2o',
9    max_runtime_secs           = 5,
10    max_runtime_secs_per_model = 3,
11    max_models                 = 3,
12    nfolds                     = 5,
13    exclude_algos              = c("DeepLearning"),
14    verbosity                  = NULL,
15    seed                       = 98765
16  )
17model_fitted <-
18  model_spec %>%
19  fit(stoxx ~ ., data = train_tbl)
Các ràng buộc chặt chẽ này giúp tạo ra một bảng xếp hạng rút gọn chỉ chứa những thuật toán cơ bản nhanh và hiệu quả nhất dựa trên chỉ số RMSE của quá trình kiểm định chéo:
Hạng một thuộc về mô hình Distributed Random Forest với sai số RMSE là 3.99. Hạng hai là Gradient Boosting Machine với sai số RMSE là 4.20. Hạng ba là Generalized Linear Model với sai số RMSE là 5.50.
1model_fitted %>%
2  automl_leaderboard()
Chiến Thắng Của Thuật Toán Distributed Random Forest
Mô hình Distributed Random Forest đã xuất sắc giành vị trí dẫn đầu trong giai đoạn kiểm định chéo nhờ khả năng tổng quát hóa dữ liệu vượt trội.
Chiến thắng của mô hình này trước thuật toán Gradient Boosting Machine vốn thường có độ chính xác cao hơn là một minh chứng thực tế rõ nét cho sự đánh đổi giữa độ chệch và độ biến động khi đối phó với dữ liệu nhiều nhiễu.
Sự biến động tài chính đồng nghĩa với việc độ biến động của dữ liệu rất cao. Chỉ số STOXX hàng ngày luôn có nhiều biến động ngắn hạn ngẫu nhiên. Mô hình Distributed Random Forest dựa vào kỹ thuật bagging để giải quyết vấn đề này. Thuật toán tiến hành huấn luyện hàng trăm cây quyết định trên các tập con ngẫu nhiên của dữ liệu và các đặc trưng, sau đó lấy trung bình dự báo của chúng. Quy trình trung bình hóa này giúp triệt tiêu các sai số ngẫu nhiên từ mỗi cây đơn lẻ một cách hiệu quả. Bằng cách ưu tiên giảm thiểu độ biến động, mô hình đã đạt được trạng thái khớp dữ liệu vô cùng ổn định để vượt qua các nhiễu động thị trường. Việc chấp nhận tăng nhẹ độ chệch thông qua cơ chế làm mượt kết quả trung bình là mức giá hoàn toàn xứng đáng để đổi lấy sự sụt giảm đáng kể của những sai số lớn do biến động gây ra.
Đánh Giá Hiệu Suất Thực Tế Trên Tập Kiểm Thử
Việc kiểm định mô hình Distributed Random Forest dẫn đầu trên tập kiểm thử mười lăm ngày cuối cùng đã xác nhận hiệu suất mạnh mẽ của nó.
Sai số RMSE đạt 10.9 trên tập kiểm thử. Mức tăng này so với giai đoạn huấn luyện là hoàn toàn bình thường đối với dữ liệu tài chính không dừng, nhưng vẫn phản ánh một kết quả dự báo rất tốt. Hệ số xác định R-squared đạt 0.537 cho thấy mô hình giải thích được hơn năm mươi ba phần trăm sự biến động của dữ liệu thực tế chưa từng thấy trong quá trình huấn luyện.
1model_tbl <-
2  modeltime_table(
3    model_fitted
4  )
5calib_tbl <-
6  model_tbl %>%
7  modeltime_calibrate(
8    new_data = test_tbl
9  )
10calib_tbl %>%
11  modeltime_accuracy()
Cuối cùng, chúng ta có thể thiết lập các khoảng dự báo để theo dõi và trực quan hóa các đường biên biến động của chỉ số tài chính.
1calib_tbl %>%
2  modeltime_forecast(
3    new_data    = test_tbl,
4    actual_data = test_tbl
5  ) %>%
6  plot_modeltime_forecast(
7    .interactive = FALSE,
8    .line_size = 1.5
9  )  +
10  labs(title = "Modeling with Automated ML for the STOXX Europe 600",
11       subtitle = "<span style = 'color:dimgrey;'>Predictive Intervals</span> of <span style = 'color:red;'>Distributed Random Forest</span> Model",
12       y = "",
13       x = "") +
14  scale_y_continuous(labels = scales::label_currency(prefix = "€")) +
15  scale_x_date(labels = scales::label_date("%b %d"),
16               date_breaks = "2 days") +
17  theme_minimal(base_family = "Roboto Slab", base_size = 16) +
18  theme(plot.title = element_text(face = "bold", size = 16),
19        plot.subtitle = ggtext::element_markdown(face = "bold"),
20        plot.background = element_rect(fill = "azure", color = "azure"),
21        panel.background = element_rect(fill = "snow", color = "snow"),
22        axis.text = element_text(face = "bold"),
23        axis.text.x = element_text(angle = 45,
24                                   hjust = 1,
25                                   vjust = 1),
26        legend.position = "none")
Dưới đây là biểu đồ trực quan hóa kết quả dự báo cùng các khoảng tin cậy của mô hình trên tập kiểm thử thực tế:
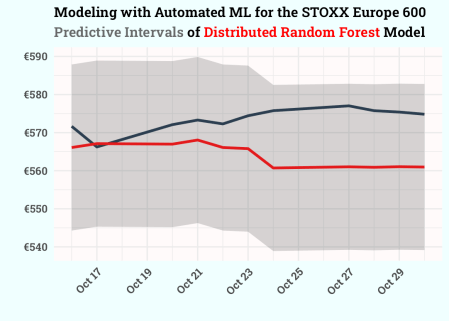
✨ Khi làm việc với các chuỗi thời gian tài chính có mức độ biến động lớn, việc cố gắng tối ưu hóa một mô hình cực kỳ phức tạp thường dẫn đến hiện tượng quá khớp dữ liệu. Việc ứng dụng công cụ học máy tự động để nhanh chóng sàng lọc và lựa chọn các mô hình ưu việt có độ biến động thấp như Distributed Random Forest giúp nhà phân tích xây dựng được các kịch bản dự báo có tính ổn định cao và giảm thiểu rủi ro đáng kể trước những cú sốc bất ngờ của thị trường.
Bài tập ứng dụng: Bạn hãy thử thay đổi số lượng ngày trễ của biến tự hồi quy trong quy trình tiền xử lý dữ liệu từ hai ngày lên năm ngày hoặc mười ngày. Việc bổ sung các biến trễ sâu hơn này có giúp cải thiện chỉ số RMSE và hệ số xác định R-squared trên tập kiểm thử của mô hình Distributed Random Forest hay không? Hãy thực thi lại mã nguồn trên và đưa ra nhận xét của riêng mình.