Trong học máy có giám sát, giá trị Shapley là phương pháp tiêu chuẩn để đo lường mức độ đóng góp của từng biến giải thích vào kết quả dự đoán của mô hình. Tuy nhiên, việc áp dụng giá trị Shapley vào bài toán chuỗi thời gian có biến ngoại sinh lại ít phổ biến hơn dù mang lại giá trị thực tiễn rất cao. Bài viết này sẽ hướng dẫn bạn cách tính toán và trực quan hóa giá trị Shapley chính xác nhằm bóc tách các kịch bản dự báo chuỗi thời gian thông qua mô hình dynrmf trong gói ahead của R.
Bản chất của giá trị Shapley trong bài toán chuỗi thời gian
Giá trị Shapley bắt nguồn từ lý thuyết trò chơi hợp tác, phân chia phần thưởng công bằng cho các bên tham gia dựa trên đóng góp cận biên của họ. Khi chuyển giao sang dự báo chuỗi thời gian, mỗi biến hồi quy đóng vai trò như một người chơi cùng tác động lên giá trị dự báo tương lai.
Thông thường, việc tính toán giá trị Shapley đòi hỏi xấp xỉ vì độ phức tạp hàm mũ khi số lượng biến tăng lên. Tuy nhiên, trong phân tích kinh tế lượng và chuỗi thời gian vĩ mô, số lượng biến hồi quy bên ngoài thường khá nhỏ, thường dưới 15 biến. Điều này cho phép chúng ta tính toán trực tiếp giá trị Shapley chính xác mà không cần xấp xỉ, đảm bảo tính toàn vẹn và độ tin cậy tuyệt đối cho phân tích kịch bản.
Xây dựng mô hình và phân tích kịch bản với R
Để minh họa, chúng ta sử dụng bộ dữ liệu uschange từ gói fpp2, ghi nhận các chỉ số kinh tế vĩ mô hàng quý của Mỹ. Mục tiêu là dự báo mức tăng trưởng tiêu dùng dựa trên ba biến giải thích: thu nhập, tiết kiệm và tỷ lệ thất nghiệp.
Quy trình triển khai bao gồm việc chuẩn hóa dữ liệu, chia tập huấn luyện và kiểm thử, sau đó huấn luyện mô hình Support Vector Machine kết hợp dynrmf để mô phỏng bốn kịch bản: cơ sở, bi quan, lạc quan và cực kỳ lạc quan.
1devtools::install_github("Techtonique/ahead")
2library(fpp2)
3library(ahead)
4library(e1071)
5library(misc)
6library(ggplot2)
7library(patchwork)
8y <- fpp2::uschange[, "Consumption"]
9xreg <- scale(fpp2::uschange[, c("Income", "Savings", "Unemployment")])
10split <- misc::splitts(y, split_prob = 0.9)
11xreg_train <- window(xreg, start = start(split$training), end = end(split$training))
12xreg_test <- window(xreg, start = start(split$testing), end = end(split$testing))
13shap <- ahead::dynrmf_shap(
14  y = split$training,
15  xreg_fit = xreg_train,
16  xreg_predict = xreg_test,
17  fit_func = e1071::svm
18)
19p1 <- ahead::plot_dynrmf_shap_waterfall(shap, title = "Baseline scenario")
20xreg_pess <- xreg_test
21xreg_pess[, "Income"] <- -1
22xreg_pess[, "Savings"] <- -0.5
23shap_pess <- dynrmf_shap(
24  y = split$training,
25  xreg_fit = xreg_train,
26  xreg_predict = xreg_pess,
27  fit_func = e1071::svm
28)
29p2 <- ahead::plot_dynrmf_shap_waterfall(shap_pess, title = "Pessimistic scenario")
30xreg_opt <- xreg_test
31xreg_opt[, "Income"] <- 2
32xreg_opt[, "Savings"] <- 0.5
33shap_opt <- dynrmf_shap(
34  y = split$training,
35  xreg_fit = xreg_train,
36  xreg_predict = xreg_opt,
37  fit_func = e1071::svm
38)
39p3 <- ahead::plot_dynrmf_shap_waterfall(shap_opt, title = "Optimistic scenario")
40xreg_ovr <- xreg_test
41xreg_ovr[, "Income"] <- 2.5
42xreg_ovr[, "Savings"] <- 0.75
43shap_ovr <- ahead::dynrmf_shap(
44  y = split$training,
45  xreg_fit = xreg_train,
46  xreg_predict = xreg_ovr,
47  fit_func = e1071::svm
48)
49p4 <- plot_dynrmf_shap_waterfall(shap_ovr, title = "Overly optimistic scenario")
50(p1 + p2) / (p3 + p4)
Đánh giá kết quả qua biểu đồ thác nước
Hàm plot_dynrmf_shap_waterfall trực quan hóa tác động cộng dồn của từng biến kinh tế vào dự báo theo định dạng biểu đồ thác nước.
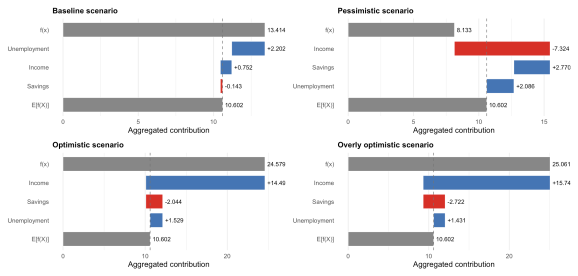
Một nguyên tắc kiểm tra quan trọng khi làm việc với giá trị Shapley là tính chất cộng: tổng giá trị Shapley của tất cả các biến phải bằng đúng độ lệch giữa giá trị dự báo và mức dự báo nền tảng. Mức dự báo nền tảng ở đây chính là kết quả mô hình khi mọi biến giải thích được thay thế bằng giá trị trung bình cột trên tập huấn luyện. Sự khớp nối hoàn hảo này giúp người ra quyết định hiểu rõ chính xác biến số nào đang thúc đẩy hoặc kéo giảm đà tăng trưởng trong từng tình huống giả định.
✨ Giá trị đắt giá: Việc tính toán giá trị Shapley chính xác trong bài toán chuỗi thời gian giúp chuyển hóa mô hình hộp đen thành một công cụ phân tích kịch bản trực quan, cho phép nhà phân tích định lượng tường tận mức độ đóng góp của từng biến vĩ mô vào dự báo tương lai mà không làm mất đi độ chính xác toán học.
Câu hỏi tư duy và bài tập ứng dụng
Khi phân tích kịch bản với số lượng biến giải thích vượt quá 15 biến, thời gian tính toán giá trị Shapley chính xác sẽ tăng theo cấp số nhân. Bạn sẽ áp dụng chiến lược tiền xử lý hoặc thuật toán xấp xỉ nào để cân bằng giữa chi phí tính toán và độ tin cậy của lời giải thích? Hãy thử thay thế thuật toán SVM trong đoạn mã trên bằng Random Forest hoặc mô hình tuyến tính để so sánh sự khác biệt trong phân bổ giá trị Shapley.