Khoá học "Lập báo cáo và phân tích dữ liệu với ngôn ngữ R" là một khóa học thực tế và chuyên sâu nhằm giúp bạn nắm vững kỹ năng sử dụng ngôn ngữ lập trình R để thực hiện phân tích dữ liệu và tạo báo cáo chất lượng cao.
Trong khoá học này, bạn sẽ được hướng dẫn từ cơ bản đến nâng cao về cách sử dụng R để xử lý và biểu diễn dữ liệu một cách hiệu quả. Bằng cách áp dụng các kỹ thuật thống kê và phân tích dữ liệu trong R, bạn sẽ có khả năng hiểu rõ hơn về các biến thể trong dữ liệu và đưa ra những phân tích chính xác.
Không chỉ giúp bạn nắm vững kỹ năng kỹ thuật, khoá học cũng tập trung vào việc tạo ra báo cáo chuyên nghiệp và ấn tượng bằng cách sử dụng RMarkdown và Quarto. Bạn sẽ học cách tùy chỉnh và tối ưu hóa báo cáo để trình bày kết quả phân tích một cách rõ ràng và dễ hiểu.
Dù bạn là một sinh viên, nhà nghiên cứu hay chuyên gia trong lĩnh vực dữ liệu, khoá học này sẽ giúp bạn trở thành một người chuyên nghiệp có khả năng sử dụng R để thực hiện phân tích dữ liệu và làm việc với dữ liệu một cách mạnh mẽ và hiệu quả
Hình thức học
- Học online qua playlist gồm các VIDEO BÀI GIẢNG tên kênh youtube của SciEco.
- Học viên học qua video và vừa có thể trao đổi để giải đáp các thắc mắc trực tiếp với giảng viên qua kênh hỗ trợ online
- Học viên làm bài tập qua tài liệu được đính kèm của video
Khoá tiêu chuẩn và Khoá cao cấp
Khoá R tiêu chuẩn (standard): học viên được truy cập và học các nội dung trong video và trao đổi thắc mắc với giảng viên qua kênh hỗ trợ online
Khoá R cao cấp (premium): Bao gồm khoá R tiêu chuẩn, ngoài ra cuối khoá sẽ có buổi tư vấn trực tiếp của học viên với PSG.TS. Lê Thanh Hà và đội ngũ giảng viên để giải đáp thắc mắc hoặc định hướng phát triển trong tương lai
Đối tượng
- Sinh viên, học viên chuyên ngành Khoa học dữ liệu, Thống kê, Khoa học máy tính, hoặc các ngành liên quan muốn nắm vững kỹ năng sử dụng R trong công việc phân tích dữ liệu và lập báo cáo.
- Các nhà nghiên cứu, nhà phân tích dữ liệu trong các lĩnh vực như tài chính, kinh doanh, y tế, xã hội học, v.v. muốn tăng cường khả năng sử dụng R để thực hiện phân tích dữ liệu và tạo báo cáo chất lượng cao.
- Các cá nhân có hiểu biết cơ bản về lập trình và thống kê, nhưng muốn học thêm về cách sử dụng R để làm việc hiệu quả hơn với dữ liệu và tạo ra báo cáo phân tích mạnh mẽ
Mục tiêu khoá học
- Xây dựng cho học viên những kiến thức nền tảng vững chắc, tạo tiền đề cho việc học các kiến thức lập trình nâng cao, phát triển nghề nghiệp.
- Cung cấp những kỹ năng cần thiết để thực hiện việc phân tích, thống kê, biểu diễn đồ hoạ và báo cáo bằng R.
- Rèn luyện và phát triển kỹ năng lập trình, tư duy logic.
Lợi ích tham gia khoá học
- Sử dụng các cấu trúc trong ngôn ngữ lập trình R để giải quyết các bài toán.
- Vân dụng các cấu trúc điều kiện, cấu trúc lặp, function.
- Sử dụng các thư viện có sẵn của R để thực hiện các công việc tính toán, thống kê.
- Làm việc với các kiểu dữ liệu tập tin như txt file, CSV file, Excel file,…
- Thiết lập các Chart và Graph, trực quan hoá dữ liệu, lập trình thống kê và lập báo cáo trong R.
- Tìm hiểu xây dựng các mô hình định lượng trong kinh tế và kinh doanh
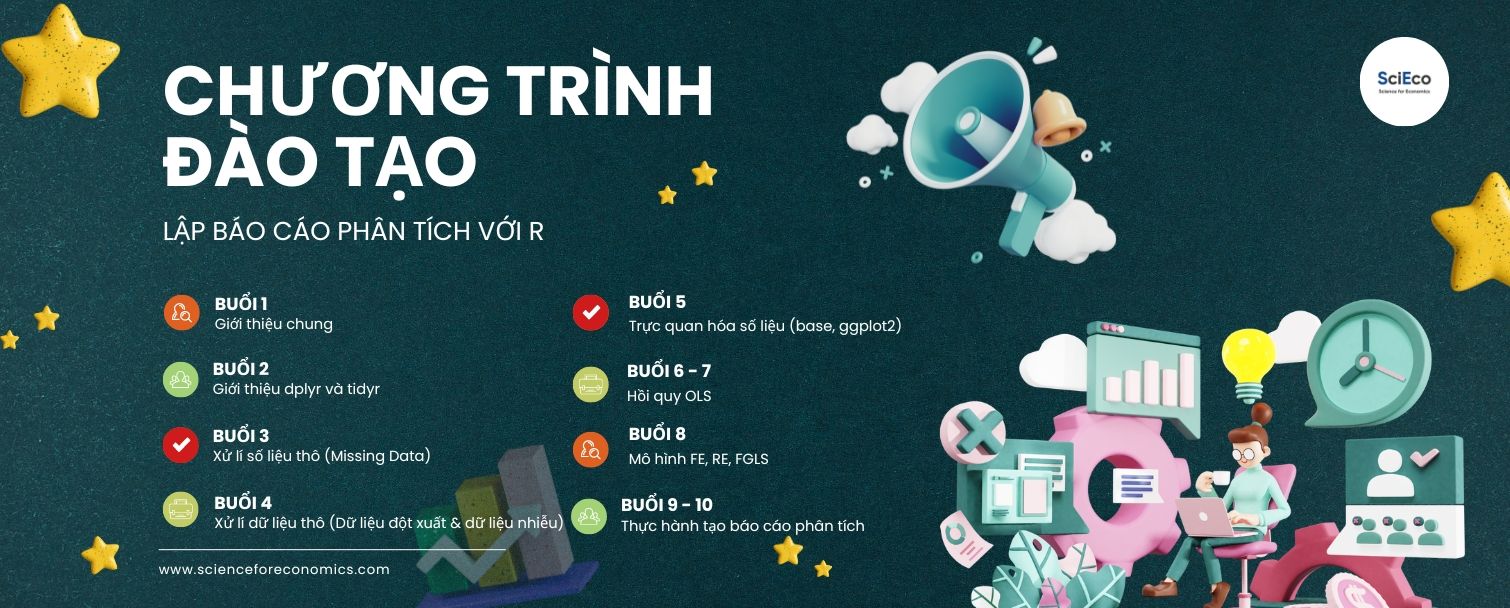
Buổi 1: Giới thiệu chung
- Giới thiệu và cài đặt R và Rstudio
- Tổ chức dữ liệu, khai báo biến, kiểu dữ liệu (character, numeric, logical date, ...)
- Cấu trúc dữ liệu: vector, data frame, list
- Giới thiệu Rmarkdown
Buổi 2: Giới thiệu dplyr và tidyr
- Thư viện
dplyr: data wrangling, lọc, sắp xếp, tổng hợp, ghép các bảng dữ liệu - Thư viện
tidyr: chuyển đổi dữ liệu (dạng wide và long)
Buổi 3: Xử lý số liệu thô (Missing Data)
- Các trường hợp khuyết thiếu dữ liệu
- Cơ chế khuyết thiếu dữ liệu (MCAR, MAR, MNAR)
- Xử lý dữ liệu khuyết thiếu:
- Xóa dữ liệu khuyết thiếu
- Nhập dữ liệu khuyết thiếu (thư viện
mice)
Buổi 4: Xử lý số liệu thô (Dữ liệu đột xuất và dữ liệu nhiễu)
- Dữ liệu nhiễu và các phương pháp xử lý
- Dữ liệu đột xuất các phương pháp để phát hiện và xử lý
Buổi 5: Trực quan hóa số liệu
- Khái niệm, ứng dụng của các loại đồ thị trong thống kê
- Sử dụng ggplot2 để vẽ các loại đồ thị đã giới thiệu từ bộ dữ liệu có sẵn
- Sử dụng highcharter để tạo báo cáo động
- Sử dụng gganimated tạo biểu đồ động
Buổi 6: Hồi quy OLS
- Hồi quy đơn (tuyến tính + phi tuyến)
- Giải thích kết quả hệ số mô hình
- Trực quan kết quả lên đồ thị
Buổi 7: Hồi quy OLS (phần 2)
- Hồi quy bội
- Hồi quy với biến giả
- Kiểm định các giả thuyết của mô hình BLUE
Buổi 8: Mô hình FE, RE
- Giới thiệu dữ liệu bảng
- Mô hình Pooled OLS
- Mô hình tác động cố định (Fixed Effects Model)
- Mô hình tác động ngẫu nhiên (Random Effects Model)
- Mô hình sử dụng biến công cụ Taylor-Hausman
- Tổng hợp kết quả mô hình bằng R
Buổi 9 + 10: Thực hành tạo báo cáo phân tích từ dữ liệu thực tế
- Tạo báo cáo tự động bằng RMarkdown và Quarto
- Tạo báo cáo chuyên nghiệp bằng R và Canva, Figma hoặc Illustrator