Trong thời đại của số hóa và khoa học dữ liệu lên ngôi, khả năng phân tích, giải mã và trích xuất thông tin hữu ích từ khối lượng dữ liệu khổng lồ là một kỹ năng không thể thiếu để giúp bạn thích nghi với yêu cầu của công việc!
Đặc biệt, với việc làm chủ STATA, phần mềm phân tích dữ liệu có giao diện thân thiện và khả năng xử lý dữ liệu mạnh mẽ sẽ là công cụ đắc lực cho bạn. Để có thể giúp bạn chinh phục STATA, SciEco ở đây để mang đến cho bạn khóa học STATA đầy hấp dẫn:
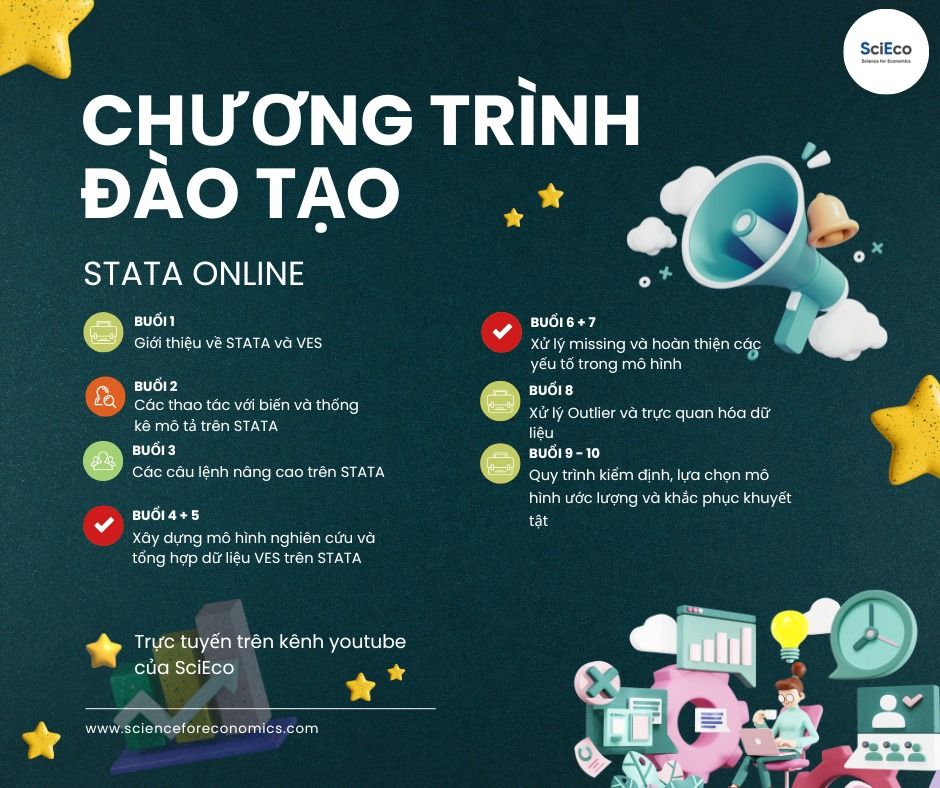
Nội dung khóa học chi tiết:
- Bài 1: Giới thiệu về STATA và VES
- Bài 2: Các thao tác với biến và thống kê mô tả trên STATA
- Bài 3: Các câu lệnh nâng cao trên STATA
- Bài 4 + 5 : Xây dựng mô hình nghiên cứu và tổng hợp dữ liệu VES trên Stata
- Bài 6 + 7: Xử lý missing và hoàn thiện các yếu tố trong mô hình
- Bài 8: Xử lý Outlier và trực quan hóa dữ liệu
- Bài 9 + 10: Quy trình kiểm định, lựa chọn mô hình ước lượng và khắc phục khuyết tật
Thông tin chi tiết:
Hình thức học: học online qua các bài giảng tên kênh youtube của SciEco.
Khóa học gồm: 10 VIDEO bài giảng vô cùng chất lượng cùng các ví dụ ứng dụng thực tế cùng bài tập về nhà
ĐẶC BIỆT
Mức giá khoá học với phần mềm STATA cực kỳ ưu đãi! GIẢM TỪ 999K CHỈ CÒN 699K dành riêng cho 20 BẠN ĐĂNG KÝ SỚM NHẤT.
Vậy còn chờ gì nữa, nhanh tay đăng ký khóa học STATA của SciEco ngay thôi! Chúng mình rất mong được gặp bạn ở SciEco
Trong hành trình phát triển các lệnh ước lượng chuyên sâu trong Stata, việc tích hợp mã nguồn từ ngôn ngữ khác như C, C++ hay Java mở ra một thế giới mới về hiệu suất và khả năng tùy biến. Một trong những kỹ thuật mạnh mẽ nhất là viết plugin — hay còn gọi là thư viện liên kết động (DLL) — để tận dụng sức mạnh của C trong môi trường Stata.
Bài viết này là phần thứ hai trong chuỗi chuyên đề “Viết một lệnh ước lượng trong Stata”, tiếp nối bài trước về việc chuẩn bị viết plugin. Ở đây, chúng ta sẽ xây dựng một plugin C thực hiện chính xác các phép tính mà hàm mymean_work() trong tệp mymean11.ado đã làm. Mục tiêu không chỉ là minh họa cách giao tiếp giữa C và Stata, mà còn cung cấp một nền tảng vững chắc cho các tính toán hiệu suất cao trong các mô hình kinh tế lượng phức tạp.
Viết một plugin C đơn giản: “Hello, C!”
Trước khi tiến vào tính toán thực tế, hãy bắt đầu bằng một ví dụ đơn giản: một plugin C hiển thị thông điệp “Hello from C” trong cửa sổ Stata. Mã nguồn cho myhello.ado được trình bày như sau:
Trong bài viết trước, chúng ta đã xây dựng một đường ống phân tích văn bản sử dụng quanteda. Quy trình đó tạo ra ma trận đặc trưng văn bản (DFM), áp dụng trọng số TF-IDF và đo lường sự tương đồng qua cosine similarity. Tuy nhiên, phương pháp này bộc lộ một hạn chế căn bản: cosine similarity tính trên các vector TF-IDF thưa chỉ phản ánh sự trùng lặp từ vựng, chứ không nắm bắt được ý nghĩa ngữ nghĩa.
Xét ví dụ hai câu: "Người vay nợ không thực hiện nghĩa vụ trả nợ" và "Khách hàng không đáp ứng được cam kết trả nợ". Sau khi loại từ dừng, chúng không chia sẻ từ vựng nào, dẫn đến độ tương đồng TF-IDF gần như bằng 0. Dù vậy, bất kỳ аналитик nào cũng nhận ra chúng mang ý nghĩa như nhau.
Giải pháp nằm ở vector nhúng dày đặc (dense embeddings) — biểu diễn thần kinh nơi các văn bản mang ý nghĩa gần nhau được ánh xạ đến các vị trí lân cận trong không gian vectơ. Nhờ đó, chúng ta có thể đo lường sự tương đồng ngữ nghĩa ngay cả khi không có từ chung.
Bài viết này sẽ hướng dẫn xây dựng một đường ống Tạo sinh tăng cường truy xuất (RAG) trong R, sử dụng ragnar cho kho truy xuất và ellmer cho tương tác mô hình ngôn ngữ lớn (LLM), minh họa sức mạnh của nhúng dày đặc trong truy xuất và sinh câu trả lời. Toàn bộ quy trình chạy cục bộ nhờ Ollama.